
EMNLP Highlight Award voor onderzoek naar haatzaaiende uitingen en desinformatie
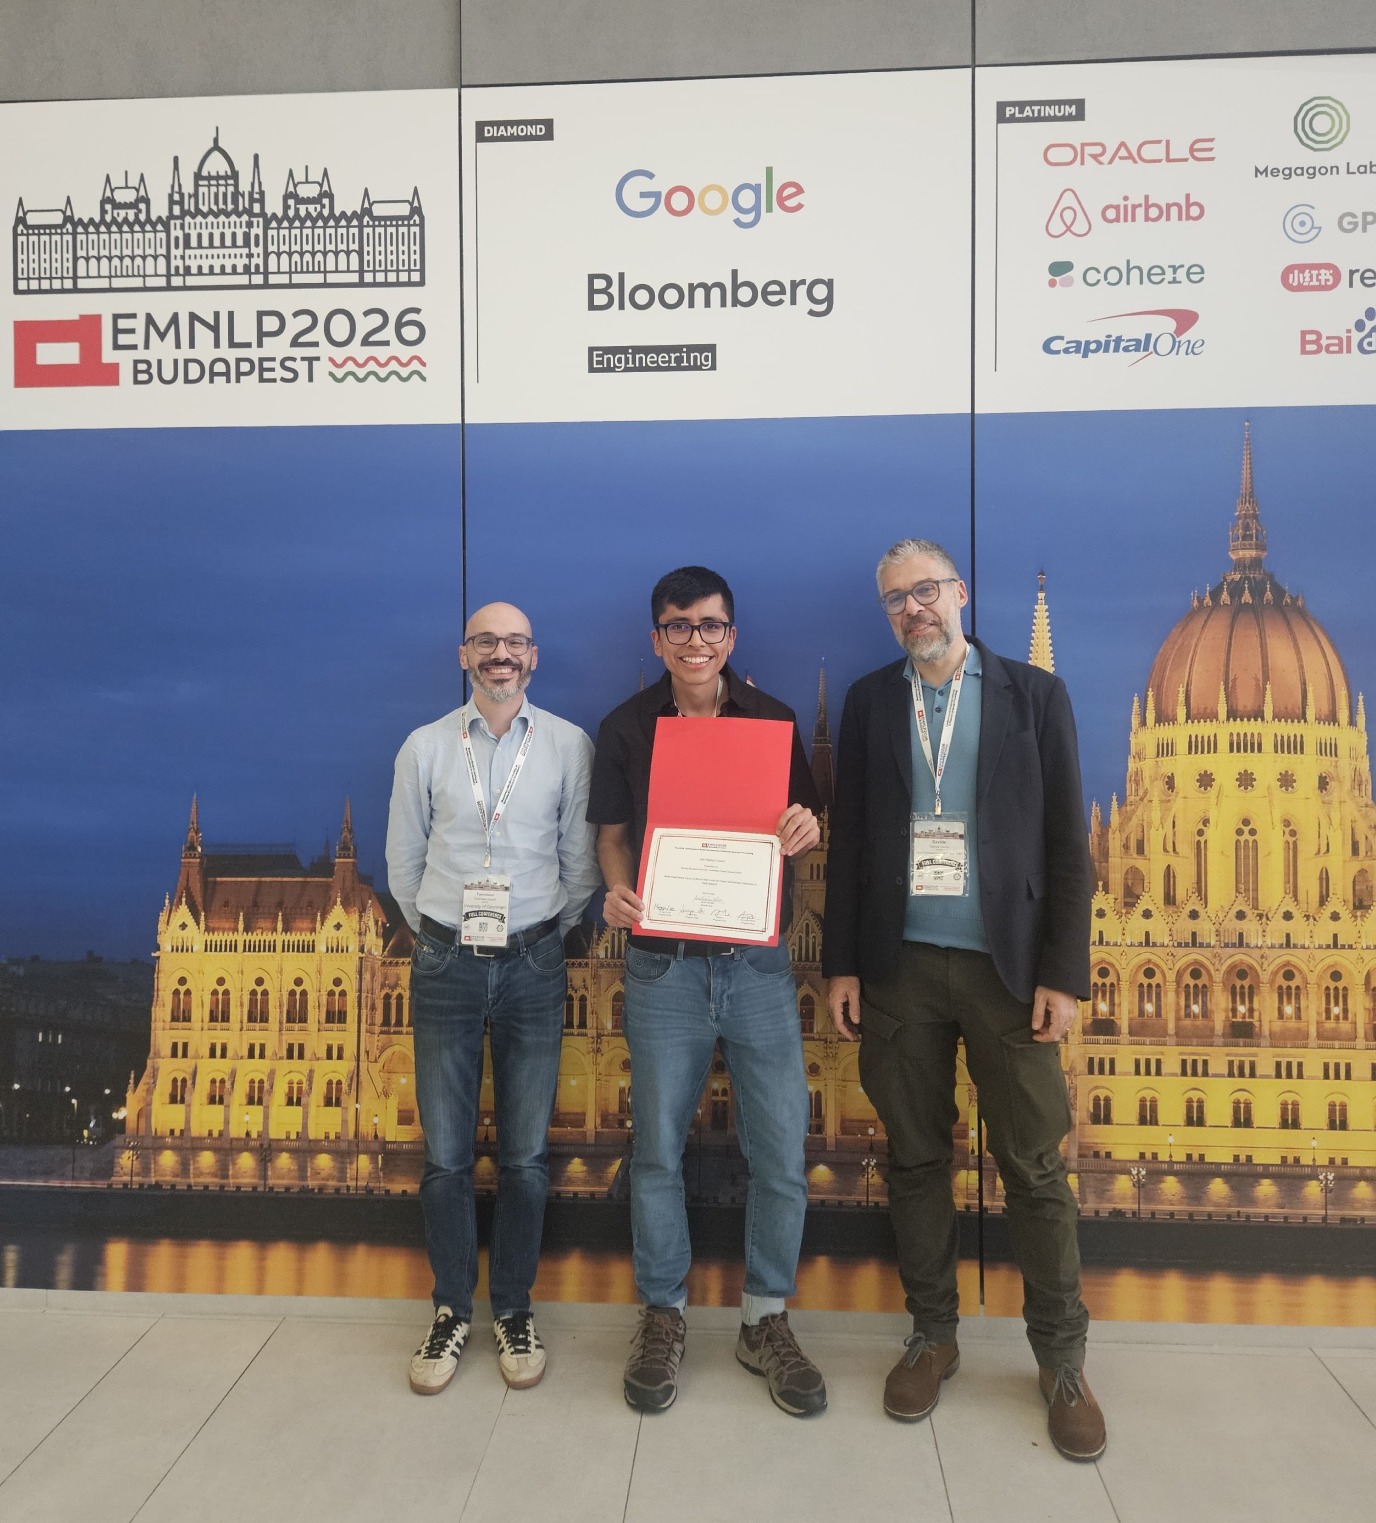
Letteren onderzoeker Tommaso Caselli, ontving samen met zijn co-auteurs Benjamín Ocampo en Davide Ceolin van het Centrum Wiskunde & Informatica (CWI) in Amsterdam, de Senior Area Chair (SAC) Highlight Award voor hun wetenschappelijke paper over de herkenning van haatzaaiende uitingen en misleidende informatie.
Caselli is universitair docent aan het Centre for Language and Cognition Groningen (CLCG) en Jantina Tammes School (JTS) scholar. Hij ontving de prestigieuze onderzoeksprijsen samen met de zijn medeauteurs tijdens EMNLP 2026, een van de toonaangevende internationale conferenties op het gebied van Natural Language Processing.
Haatzaaiende berichten vermomd als feiten
Online haatzaaiende uitingen bestaan niet alleen uit beledigingen of bedreigingen. Ze bevatten regelmatig beweringen die als feiten worden gepresenteerd, maar niet noodzakelijk waar zijn. Dat gebeurt bijvoorbeeld in extremistische propaganda en bij gecoördineerde online intimidatie campagnes. Door dergelijke beweringen kunnen vooroordelen en schadelijke stereotypen worden versterkt. Ook kunnen omstanders psychologische schade ondervinden en kan het publieke debat worden vertroebeld.
Voor moderatoren maakt dit het beoordelen van berichten extra ingewikkeld. Zij moeten niet alleen vaststellen of een bericht haatzaaiend of schadelijk is, maar ook beoordelen of de beweringen erin feitelijk kloppen. Dat vraagt om aanvullende controle en kost daardoor meer tijd.
Nieuwe dataset en inzet van AIIn het onderzoek, getiteld When Hate Meets Facts: LLMs-in-the-Loop for Check-worthiness Detection in Hate Speech, presenteren de onderzoekers een nieuwe dataset waarin informatie over haatzaaiende uitingen wordt gecombineerd met gegevens over de vraag of beweringen in berichten controle op hun feitelijke juistheid verdienen.
Daarnaast ontwikkelden de onderzoekers een nieuwe methode waarbij grote taalmodellen (Large Language Models, LLM's) ondersteunen bij het herkennen en annoteren van controleerbare beweringen.
Betere herkenning van online haat
Het onderzoek laat ook zien dat berichten met haatzaaiende uitingen én beweringen die controle op hun juistheid verdienen, gemiddeld meer haat en intimidatie bevatten. Bovendien verbetert de herkenning van haatzaaiende berichten door taalmodellen aanzienlijk wanneer informatie over de controleerbaarheid van beweringen wordt meegenomen.
Met de combinatie van een nieuwe dataset en een AI-ondersteunde annotatiemethode bieden de onderzoekers aanknopingspunten om online haat en misleidende informatie effectiever te herkennen en te bestrijden.
Meer nieuws
-
29 oktober 2026
Opinie | De gebroken macht herstellen
-
-
26 oktober 2026
Trump als Koning Midas